Le vrai coût d'un visuel généré
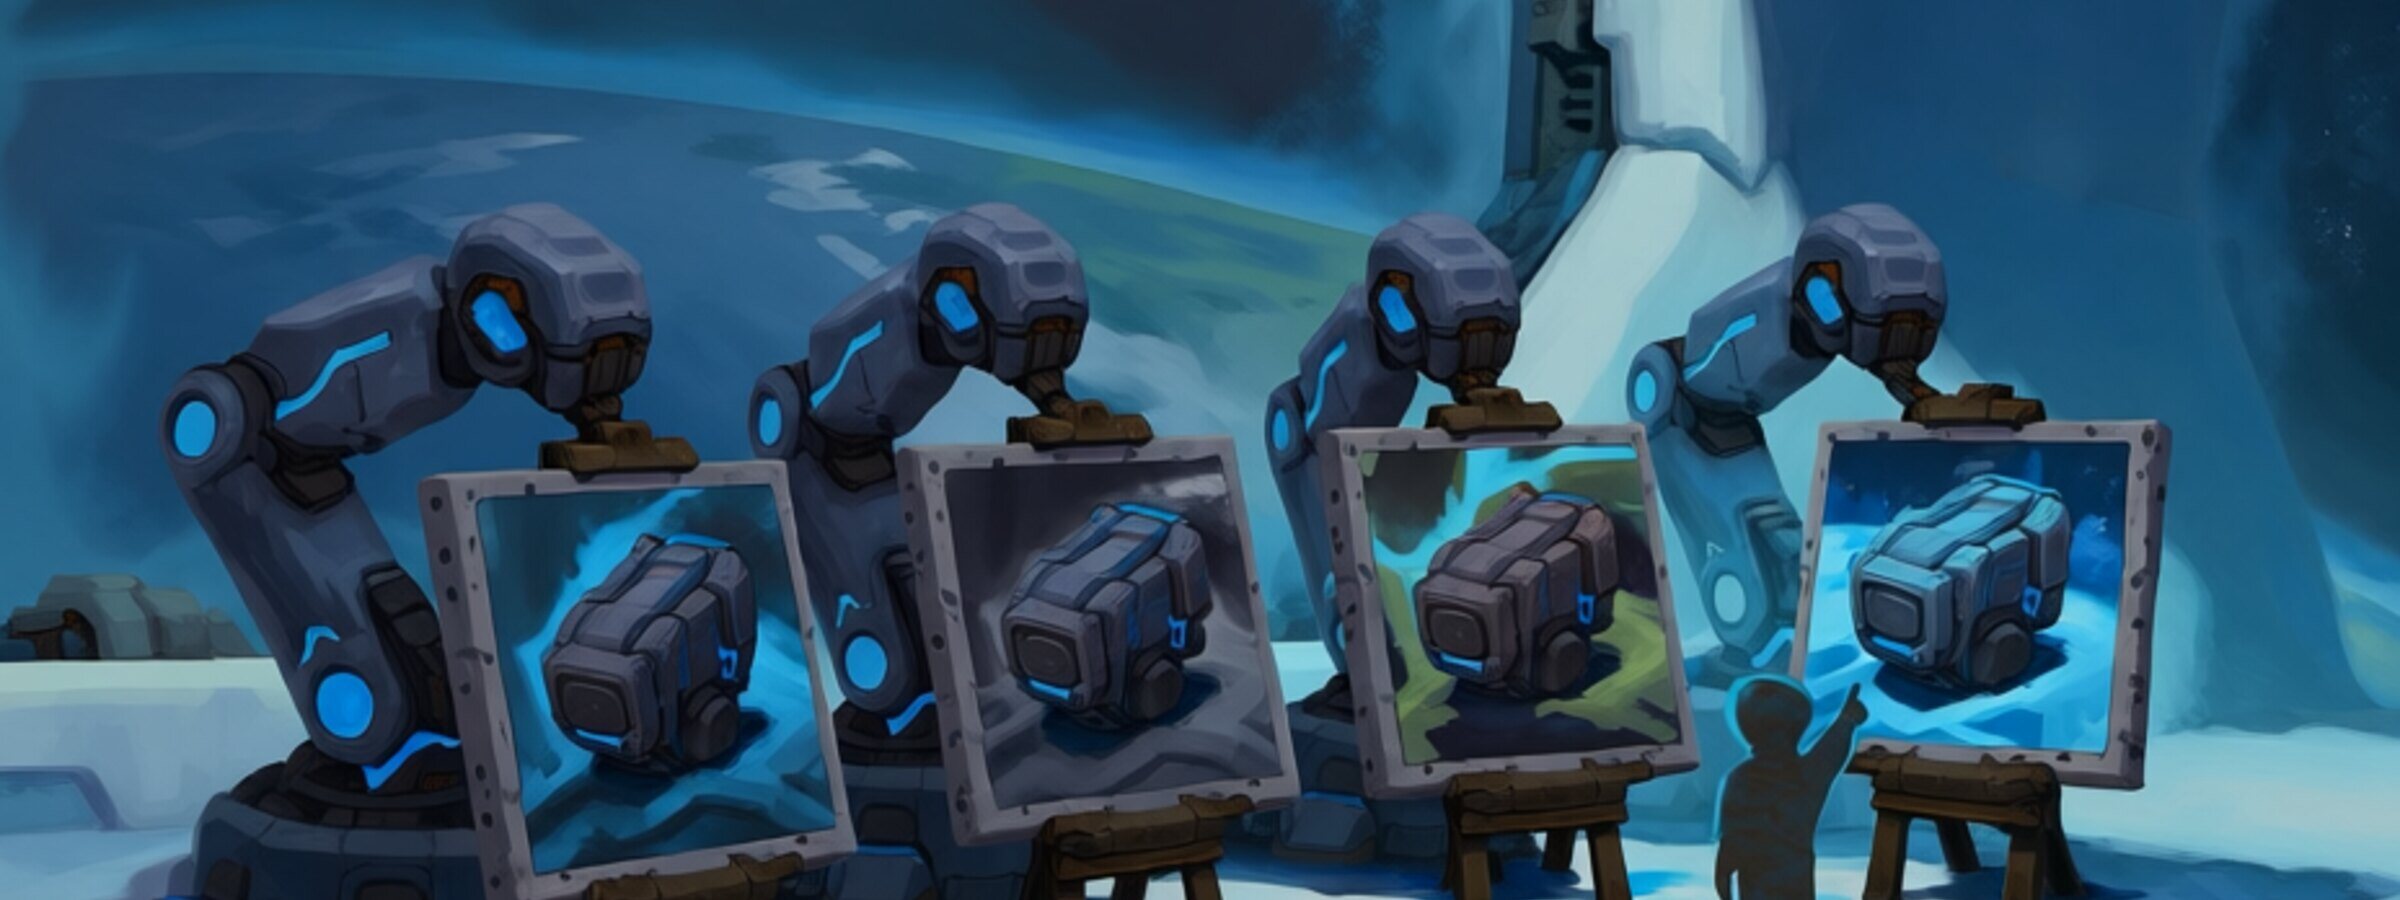
Générer une image coûte quelques secondes. En générer une utilisable, c'est une autre affaire. Je développe Dynasty Nova, un jeu de gestion spatiale. Pendant sa refonte visuelle, la question n'était pas « est-ce que l'IA sait dessiner un excavateur ? ». C'était : « combien de tirages pour un excavateur qui tienne dans une carte de 179 × 224 pixels, sous un voile sombre, à côté de 60 autres ? ».
La réponse dépend d'un seul nombre, que nous appelons p : la part des tirages recevables. Et pour mesurer p, il faut une règle qui dise ce qu'est un tirage recevable. C'est le rôle de la grille d'acceptation.
Pourquoi figer la grille avant de générer
Notre grille a été figée le 16 septembre 2026, avant toute génération. Ce n'est pas un détail de procédure, c'est ce qui lui donne une valeur.
Une grille écrite après coup enregistre un goût
Une grille rédigée en regardant les images finit toujours par décrire les images qu'on aime déjà. Elle ne mesure plus rien : elle justifie. Figée avant, elle répond à une seule question binaire, « ce tirage est-il recevable ? », et jamais à « lequel est le plus beau ? ».
Noter quelle porte a rejeté
Chaque rejet est conservé avec le niveau qui l'a écarté. Au bout d'une campagne, la répartition des rejets dit où se trouve le problème : un prompt mal écrit, un modèle qui n'y arrive pas, ou un cadrage qui ne tient pas dans l'interface.
Changer un seuil se date et se justifie
Tout changement de seuil invalide les p mesurés avant lui. Il doit être daté, motivé, et accompagné d'une remesure ou de la mention que les chiffres antérieurs ne sont plus comparables. Sans cette discipline, on compare des campagnes qui n'ont pas été jugées avec la même règle.
Niveau 0 : ce qui s'écarte automatiquement
Le premier niveau est entièrement mesuré par un script, sans regard humain. Il vise les défauts qui ne se discutent pas, parce qu'ils viennent de la façon dont le jeu affiche l'image.
Format et doublon
- Format → un carré, au pixel près, d'au moins 1 024 de côté : la carte recadre en 4:5 depuis un carré.
- Doublon → une signature 64 × 64 en gris doit différer d'au moins 1 % de tout autre visuel du jeu, toutes familles confondues.
Encombrement des coins
La carte pose un bouton en haut à gauche, un compteur de niveau en bas à droite et un dégradé sur la diagonale. Un coin chargé de détails sera donc masqué. Le script compare chaque coin occulté à son miroir sur la même ligne, jamais à la moyenne de l'image, parce que le haut est du ciel et le bas du sol :
- encombrement = (détail haut-gauche / détail haut-droite) × (détail bas-droite / détail bas-gauche) ;
- seuil → 2 au maximum.
Luminance sous le voile
Presque chaque image passe sous un voile sombre dans l'interface. Une image trop sombre y disparaît. Le plancher est posé par famille, 10 % sous le visuel le plus sombre déjà en production : 29 pour les vaisseaux (sur fond d'espace), 55 pour les défenses, 64 pour les recherches, 67 pour les bâtiments. Un seuil unique aurait rejeté tous les vaisseaux.
Banalité
Un nouveau visuel doit rester à au moins 20 % de son plus proche voisin dans la même famille, une fois posé dans la carte. Ce seuil est calibré sur la paire la plus serrée de la production (Intercepteur et Prédateur, 22,3 %). Piège découvert en route : sans exclure les tirages frères d'une même entité, six tirages sur huit du Cuirassé se rejetaient… contre leurs propres frères.
Ce que les pixels ne voient pas
Nous avons mesuré la séparation entre les 462 paires de visuels de production. Passées en gris, elles en conservent 97 % en médiane. La confusion entre deux visuels est donc sémantique : deux images se confondent parce qu'elles montrent le même genre d'objet, pas parce qu'elles ont la même couleur. Aucune mesure de pixels ne le verra, et une porte qui prétendrait le faire mentirait.
Niveau 1 : ce que l'image montre
Chaque ligne se répond par oui ou non, jamais par une note :
- le sujet est l'objet demandé, pas un voisin de la même famille ;
- rien d'étranger à l'univers (« est-ce que j'ajouterais un mouton ou un donut ici ? ») ;
- la palette est celle de la famille ;
- aucun texte, glyphe ou logo ;
- le motif de forme annoncé par le prompt est reconnaissable.
Niveau 2 : sa tenue dans l'interface
- le sujet survit au recadrage 4:5 ;
- la silhouette reste lisible en vignette ;
- en gris, l'entité se distingue encore de sa plus proche voisine ;
- les coins masqués ne portent rien qu'on regretterait.
Pour juger en situation plutôt que sur le carré source, un petit outil rend l'image sur ses supports réels (bannière, carte, vignette ronde) avec le voile et le recadrage exacts. C'est la même logique que nos tests UX sans budget : observer l'élément dans son contexte, pas isolé.
De p au coût d'une campagne
Une fois la grille en place, p devient le pilote de tout le chantier.
Combien d'images par visuel
- p = 20 % → 6,8 images par entité en moyenne, soit 415 pour 61 entités.
- p = 40 % → 4,6 images, soit 280.
- p sous 10 % → le problème est le prompt, pas le tirage : on corrige le gabarit, sur une seule entité d'abord.
Pourquoi des lots de quatre
Le lot de quatre n'est le bon choix que si un lot stérile se relance tout seul. Sinon, la traîne retombe sur l'humain : à p = 15 %, 27 % des entités demandent trois tours ou plus. Dans ce cas, un lot de huit redevient préférable. Au-dessus de 30 %, un lot plus petit devient envisageable. Le rapport de campagne affiche p avec un intervalle de Wilson, pour ne pas surinterpréter dix tirages.
Ce que la campagne réelle a fait de la grille
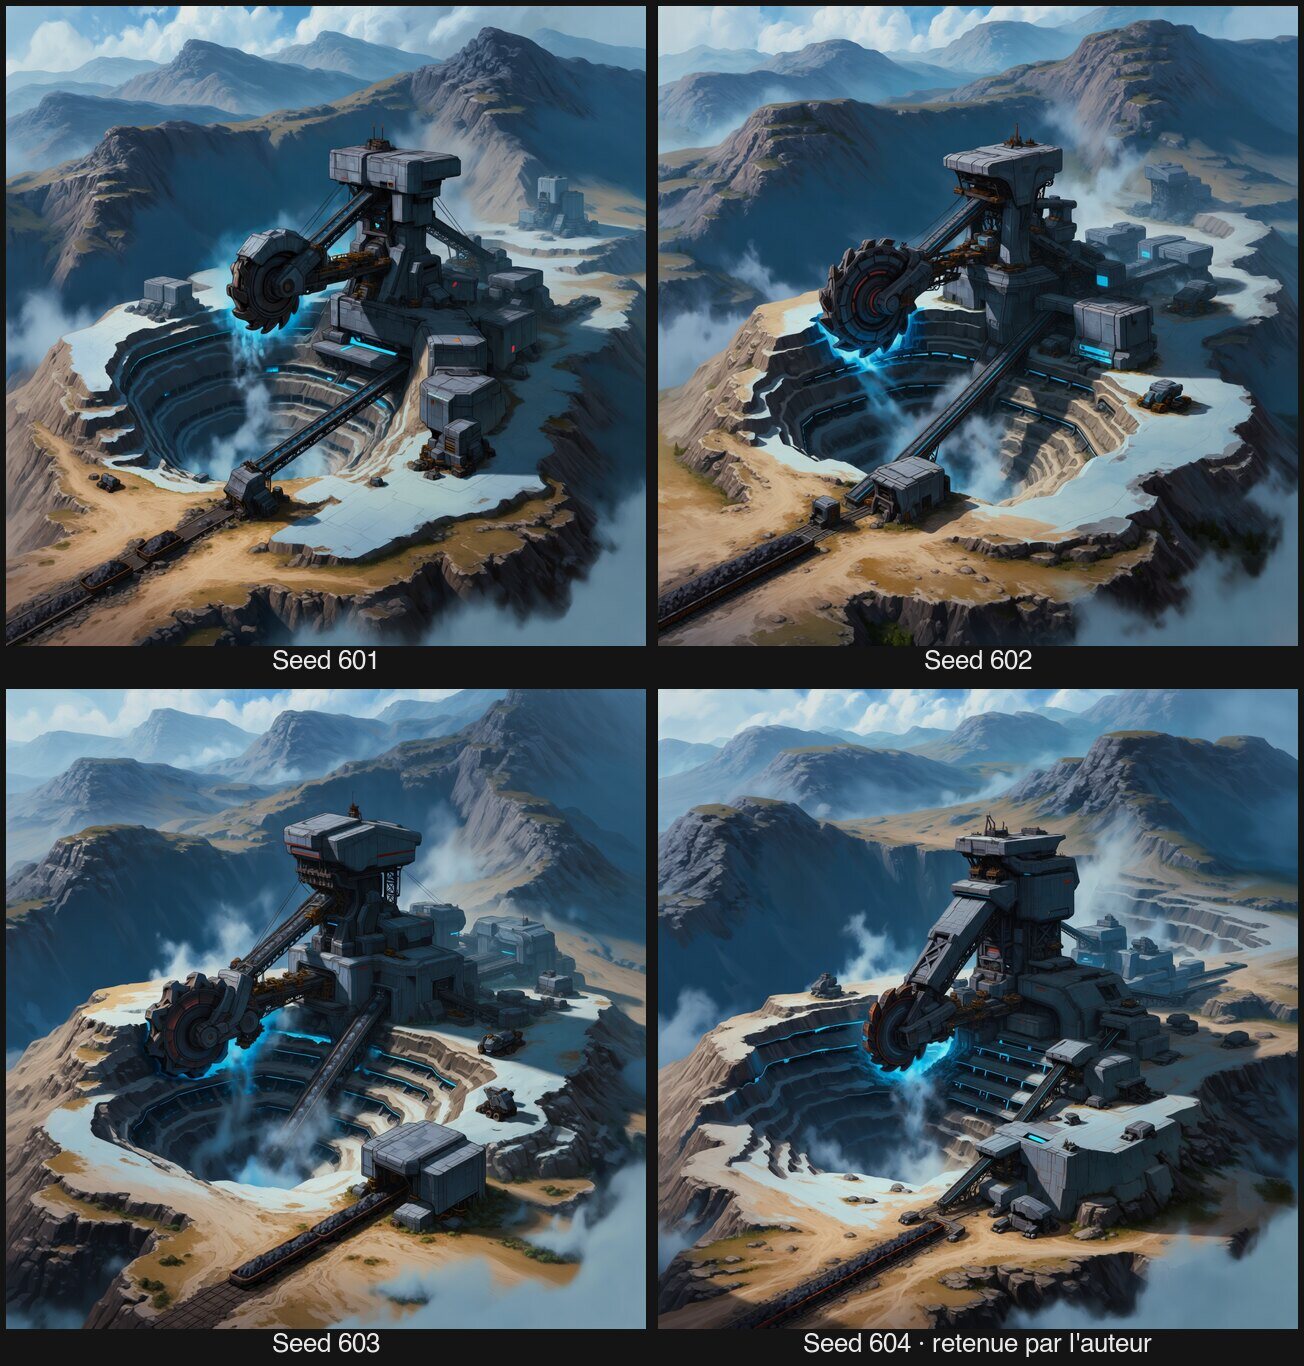
Par honnêteté, voici ce qui s'est réellement passé : la campagne v6 a tiré 244 images (quatre par entité, un seul tour) et l'auteur a choisi les 61 visuels à l'œil. Les portes automatiques n'ont pas été rejouées sur ces tirages, donc p n'a pas été mesuré pour cette version.
Un indice laissé par les choix
Les choix montrent une asymétrie curieuse : les seeds 603 et 604 ont été retenues deux fois plus souvent que 601 et 602 (5, 13, 22 et 21 fois). Effet de seed ou hasard ? Sans p mesuré, impossible de trancher. C'est exactement le genre de question qu'une grille appliquée permet de résoudre.
La règle qui reste
La règle qui a tenu toute la campagne tient en une phrase : les mesures écartent, elles ne choisissent pas. L'agent qui génère compose, tire et mesure ; tout ce qui relève du goût (la variante retenue, la direction artistique, l'étalonnage) revient à l'auteur. Nous l'avons détaillé côté outils dans notre guide des agents et du MCP dans Figma.
Conclusion
Une grille d'acceptation ne rend pas les images plus belles. Elle rend la production prévisible : on sait combien coûtera un chantier, où se trouve un problème, et si une campagne fait mieux que la précédente. Pour un designer, c'est la même posture que face à un test utilisateur ou à une mesure de contraste APCA : décider des critères avant de regarder le résultat.
Dans la même série
- Le style vient des images, pas du prompt
- Refondre la direction artistique d'un jeu par navigateur
- Garder le même visage avec Nano Banana Pro
- Des planètes 3D mesurées dans le moteur du jeu
- Un agent IA pour produire les visuels d'un jeu